Ruby 设计 - 开发日志
1 产品 Product
1.1 创建 Product
创建名为 project 的 rails 应用
rails new project |
创建 Product 模型
创建名为 project 的 rails 应用
rails new project |
创建 Product 模型
在非登录状态可以进行一些网页的浏览和功能,比如说商品目录
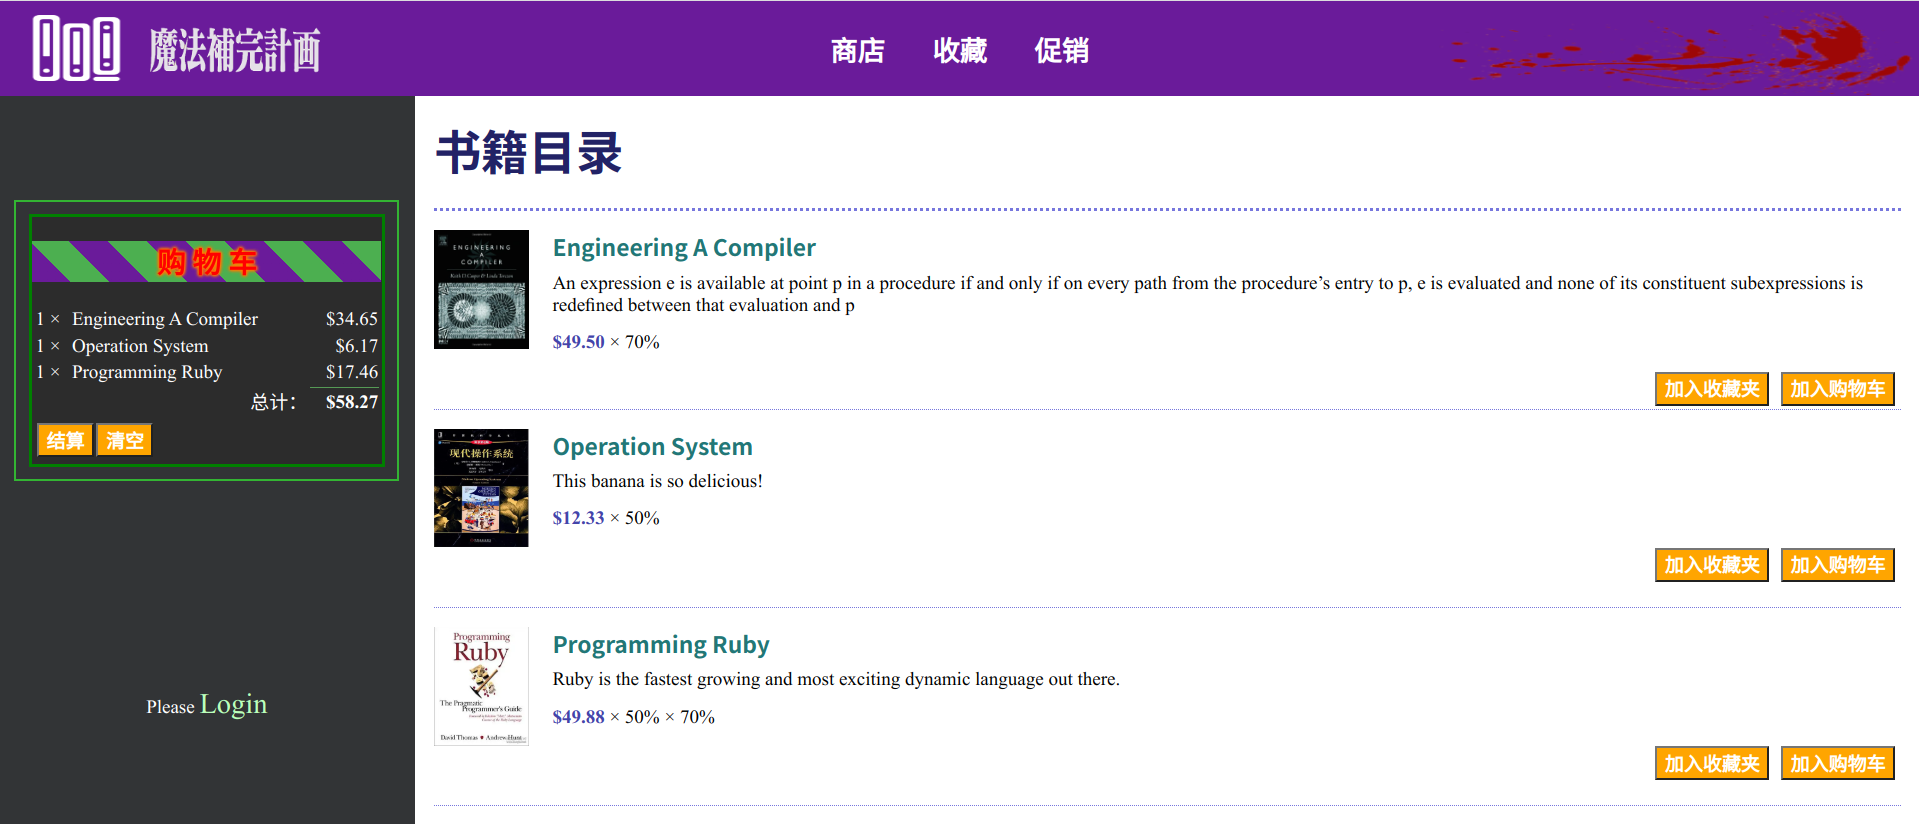
但是比如说需要支付订单的时候,就会自动重定向到登录界面。
该项目名为 “魔法补完计划”,是一个简易的电商平台,针对于一个书商,多个购书用户进行开发。
用户可以浏览商家上架的所有商品,并且可以了解这些商品的基本信息,包括商品图片,商品描述,商品价格,商品折扣等信息。
llvm 是 SSA 形式的,但是在没有经过 mem2reg 的时候,SSA 是内存形式的,也就是说,对于每个变量,只要在定义他的时候,为他在内存中划分空间存入,在使用他的时候在取出来,这样就可以达到 SSA 的效果。这是因为 SSA 只要求我们不能改变一个已经定义的值,改变内存的内容显然并不违法 SSA。
这会导致当我们提到(也就是查询)一个局部变量的时候,其实是从符号表中取出来的是它的指针,这个过程一般发生在 LVal。一般我们会对变量干两件事情,读变量和写变量和做实参。对于读变量,一般发生在 LVal 作为 PrimaryExp 的时候发生,此时需要在 PrimaryExp 中对其进行 Load,而写变量一般发生在 LVal 在 AssignStmt 和 InStmt 中,只需要用 Store 将其写入即可。做实参要单独挑出来讲,是因为它的逻辑是与 C 需要保持一致的,他是有指针类型的,这就要求我们对他进行单独的处理。这就是内存式 SSA 的基本逻辑。
错误处理和解析生成中间代码的过程是类似的,都可以看做是一个语法制导翻译的过程。对于遍历出的节点,触发不同的动作符号,这些动作符号在错误处理中用于检测错误,而在生成中间代码生成中,这些动作符号用于生成中间代码。
错误处理会遍历语法生成树,CST 的每个节点都实现了 check 方法用于检查有没有错误。
这里是 Pansy 编译器的 parser
Parser 的目的是为了根据语法获得一个具体语法树(Concrete Syntax Tree,CST)。这棵语法树的非叶子节点是各个语法成分,而叶子节点则是 Token (或者说包含 Token)。强调这个是因为我没有意识到可以将 Token 与其他语法成分等量齐观。
在文法中,我们约定非叶子节点采用首字母大写的驼峰命名法,比如 CompUnit,而对于叶子节点,我们采用全大写的形式,比如 IDENFR 。
相比于各种学长压缩语法树,在语法解析的时候直接获得抽象语法树(Abstract Syntax Tree,AST)的设计,我觉得我这个设计是更加适合应试的,因为考试的题目是要依托于文法的,AST 忽略或者说提炼了部分的文法信息,这就导致与原有文法的不契合。而且这种 “将语义信息隐藏在语法中” 的设计思想,和我个人性格更符。